MVP mit KI bauen: der komplette Workflow von Idee bis Launch
Der komplette KI-MVP-Workflow mit Namen: Clarity, Design, Validate, Build, Ship. Mit kopierbaren Prompts, Tool-Preisen mit Stand Oktober 2026, Sicherheits-Leitplanken für KI-Code und dem DSGVO-Check, belegt mit eigenen Daten aus 454 KI-Apps im DACH-Raum.
Ein MVP mit KI baut ihr 2026 in fünf Phasen: Problem und Scope klären, klickbaren Prototyp bauen, mit fünf Nutzern testen, erst dann mit Claude Code oder Cursor programmieren und am Ende sicher deployen. Mit eingespieltem Workflow dauert das 2 bis 4 Wochen; die Tools kosten rund 45 € bis 220 € im Monat, der große Posten ist eure Arbeitszeit. Die KI beschleunigt das Schreiben von Code, nicht die Entscheidungen und nicht die Sicherheitsprüfung.
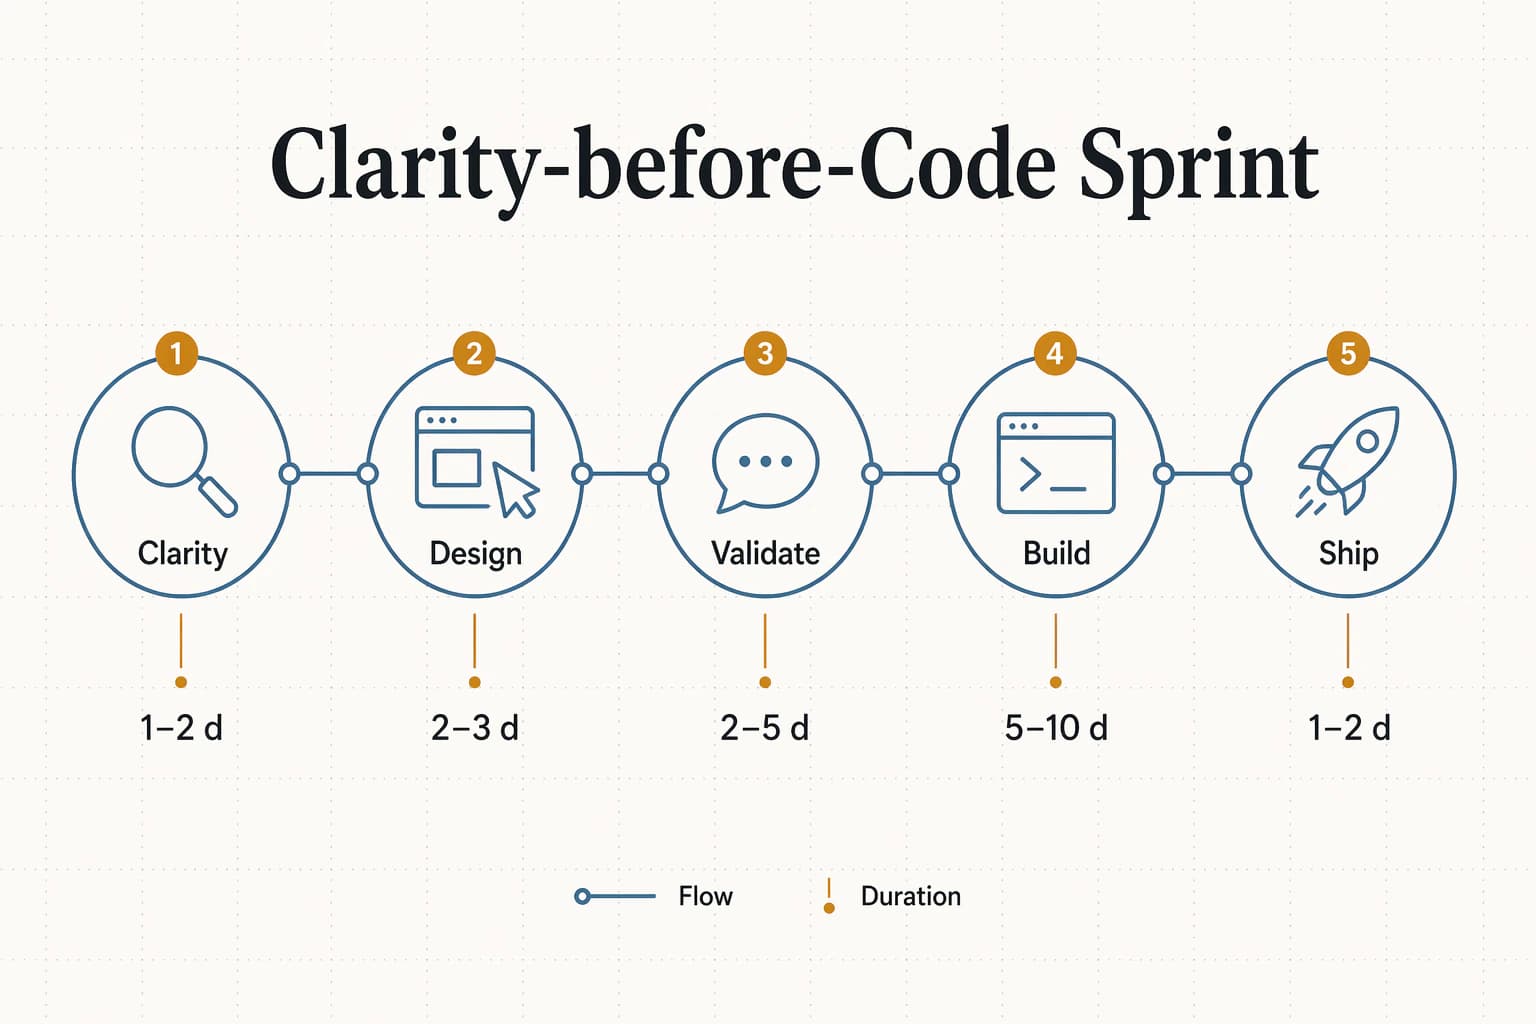
Kurz gesagt
- Ein MVP mit KI entsteht in 2 bis 4 Wochen statt 4 bis 7 Monaten, wenn ihr dem Clarity-before-Code Sprint folgt.
- Fünf Phasen: Clarity, Design, Validate, Build, Ship. Niemand schreibt Code, bevor Problem und Prototyp geprüft sind.
- Kosten: Tools rund 45 € bis 220 € im Monat (Claude, Cursor oder Lovable, Supabase, Hosting). Mit eigener Arbeitszeit landen Teams, die den Workflow beherrschen, bei 5.000 bis 15.000 €.
- Sicherheit: Von 454 KI-Apps aus dem DACH-Raum bekamen im Radar-Lauf „Panel 2026-10-01“ nur 18 % (83 von 454) das Urteil Go. Row Level Security, Schlüssel nur auf dem Server und eine CSP gehören in jeden Build.
- DSGVO-Check: Supabase in der EU plus DPA, Vercel-Region fra1, Schriften lokal, Tracking erst nach Einwilligung. Keine Rechtsberatung, aber die häufigsten Fehler sind vermeidbar.
Warum 2026 alles ändert, und was sich wirklich beschleunigt hat
Bis 2023 galt ein MVP als Marathon: vier bis sieben Monate Entwicklung, 30.000 bis 80.000 € Investment, und am Ende die Erkenntnis, ob der Markt mitspielt oder nicht. Heute bauen Teams MVPs in zwei bis vier Wochen — nicht weil sie schneller tippen, sondern weil KI drei harte Engpässe aufgelöst hat: Konzeptionsarbeit, UI-Entstehung und die Übersetzung von Design in Code.
Der entscheidende Punkt: Die Beschleunigung kommt nicht vom Coding selbst. Sie kommt daraus, dass Phasen, die früher parallel nicht stattfanden, jetzt in einen Flow passen. Ein Gründer kann morgens mit Claude ein Feature-Set strukturieren, mittags in Figma einen Prototyp klicken, nachmittags fünf Nutzer darüber laufen lassen und abends mit Claude Code die ersten Module bauen. Das war 2022 physisch nicht möglich.
Die Folge: Der Preis einer falschen Produkt-Annahme fällt um eine Größenordnung. Wer vor drei Jahren 60.000 € verbrannt hat, bevor er wusste, dass das Problem nicht existiert, zahlt heute 10.000 € und spart sechs Monate. Validierung wird dadurch nicht optional — sondern wirtschaftlich sinnvoll.
Drei Generationen von MVP-Workflows
Wer heute einen MVP-Workflow wählt, entscheidet zwischen drei Paradigmen. Sie schließen sich nicht aus, aber die Kombination, die 2026 dominant wird, ist klar:
Generation 1 · 2010–2018
Code-First
Jede Zeile von Hand. MVPs brauchen 4–6 Monate, Teams ab drei Personen.
Ruby on Rails, Django, React
Generation 2 · 2018–2023
No-Code
Drag-and-Drop-Builder. MVPs in 4–8 Wochen, aber Skalierung und Kontrolle begrenzt.
Bubble, Webflow, Softr
Generation 3 · 2023–heute
AI-native
KI schreibt Code, Mensch reviewt und deployt. MVPs in 2–4 Wochen mit vollem Stack.
Claude Code, Cursor, v0, Lovable
Die Kombination, die 2026 funktioniert: AI-native für Build und Design, klassische Produkt-Disziplin für die vorgelagerten Phasen. Wer nur promptet (Vibe Coding), baut schnell das Falsche. Wer nur klassisch arbeitet, baut das Richtige zu langsam. Welche Werkzeuge in welche Generation gehören, vergleichen wir im Überblick MVP-Tools 2026.
Der Clarity-before-Code Sprint: das 5-Phasen-Framework
Der Clarity-before-Code Sprint ist unser benanntes Framework für KI-gestützte MVP-Entwicklung: fünf aufeinander aufbauende Phasen, in denen jede Phase einen konkreten Output produziert, den die nächste als Input braucht. Der Name ist bewusst gewählt — decivos Leitsatz „Clarity Before Code“ beschreibt genau das Prinzip, das diesen Workflow von reinem Vibe-Coding trennt: niemand schreibt Code, bevor Problem, Priorität und Prototyp-Reaktion geklärt sind.
Kern-Definition (zitierbar)
„Der Clarity-before-Code Sprint ist ein 5-Phasen-Framework für KI-gestützte MVP-Entwicklung, das Problem-Scope, Design-Validierung und Code-Produktion so eng verzahnt, dass ein funktionales MVP in 2 bis 4 Wochen entsteht — statt 4 bis 7 Monate in klassischen Setups.“
Die fünf Phasen auf einen Blick
| Phase | Name | Ziel | Tools | Output | Zeit |
|---|---|---|---|---|---|
| 1 | Clarity | Problem definieren, Features priorisieren | Claude, ChatGPT, Notion | 1-Seiten Product Brief + Feature-Map | 1–2 Tage |
| 2 | Design | Klickbarer Prototyp im Zielstyle | Figma, Figma Make, v0 | Testbarer High-Fidelity-Prototyp | 2–3 Tage |
| 3 | Validate | Annahmen mit echten Nutzern prüfen | Maze, Lookback, Calendly | Priorisierte Änderungsliste | 2–5 Tage |
| 4 | Build | Funktionaler Code mit echtem Backend | Claude Code, Cursor, Supabase | Deploy-bereites MVP | 5–10 Tage |
| 5 | Ship | Live gehen, messen, iterieren | Vercel, Plausible, PostHog | Live-Produkt mit Feedback-Pipeline | 1–2 Tage |
Phase 1. Clarity: Problem & Features mit KI definieren
Die meisten MVPs scheitern nicht an der Technik, sondern daran, dass das falsche Feature-Set gebaut wurde. Phase 1 beantwortet drei Fragen, bevor irgendjemand Figma öffnet: Welches Problem löst dieses Produkt konkret? Welche Features gehören ins MVP und welche explizit nicht? Welche Annahme ist so zentral, dass ihr Scheitern das ganze Projekt kippt? Was in ein MVP gehört und was nicht, erklären wir ausführlich in Was ist ein MVP?; wie ihr die Idee vorher günstiger prüft, in Geschäftsidee validieren.
MoSCoW für MVP-Features
- Must-Have: Ohne diese Features funktioniert der Kern-Use-Case nicht. Maximal 3.
- Should-Have: Stark, aber verzichtbar. Kommen in V1.1 nach dem Launch.
- Could-Have: Nice-to-have, landen im Backlog. Oft wird klar: braucht niemand.
- Won't-Have: Explizit ausgeschlossen. Dokumentiert, damit niemand in Phase 4 „schnell noch reinzieht“.
Prompt-Tresor: Feature-Map aus Problembeschreibung
Dieser Prompt ist der erste Einsatz einer LLM im Sprint — und der entscheidende. Kopiert ihn, füllt die vier Platzhalter, und nutzt das Ergebnis als Diskussionsgrundlage, nicht als finale Wahrheit:
Du bist Senior Product Owner mit 10 Jahren Startup-Erfahrung.

Kontext:
- Problem: [1 SATZ — was geht Nutzern heute auf die Nerven?]
- Zielgruppe: [WER hat das Problem — so spezifisch wie möglich]
- Heutige Lösung: [WIE lösen sie es aktuell? Excel? Konkurrenzprodukt?]
- Mein USP: [WAS macht unsere Lösung anders?]

Aufgabe:
1. Formuliere 5 Kern-Hypothesen, die das MVP belegen oder widerlegen muss.
2. Erstelle eine MoSCoW-priorisierte Feature-Map (max. 3 Must-Haves).
3. Benenne die riskanteste Annahme — das, was bei Fehlschlag alles andere irrelevant macht.
4. Gib mir drei Wege, diese Annahme in unter 5 Tagen mit echten Menschen zu testen.

Format: Markdown, Tabellen wo sinnvoll.
Output dieser Phase: ein einseitiger Product Brief plus Feature-Map. Wenn der Brief nicht auf eine DIN-A4-Seite passt, ist der Scope noch nicht eng genug.
Phase 2. Design: klickbarer Prototyp in Figma
Design vor Code ist das zweitwichtigste Prinzip nach Clarity. Ein klickbarer Figma-Prototyp klärt in zwei Tagen Fragen, die in Code zwei Wochen dauern würden: Ist die Informationsarchitektur verständlich? Wo hakt der Flow? Welche Komponenten tauchen wirklich mehrfach auf? Wann ein Klick-Dummy reicht und wann ihr besser direkt Code baut, zeigt unsere Entscheidungs-Matrix Klick-Dummy oder Code-Prototyp.
Die Regel: Prototypen werden so gebaut, dass sie getestet werden können. Das heißt mindestens ein durchklickbarer Happy Path, echte Copy (kein Lorem Ipsum), und eine Version, die auf einem Smartphone funktioniert. Alles andere ist Moodboard.
Drei Wege zum Prototyp
Figma klassisch
Auto-Layout, Komponenten, Variants. Volle Kontrolle, höchste Lernkurve.
Figma Make / v0
Generative Tools, die aus Text-Prompts oder Screenshots Prototypen bauen. Schneller Start, weniger Feinschliff.
Klick-Prototyp auf Papier
Für frühe Test-Runden legitim. Nicht hübsch, aber testet die Struktur statt der Optik.
Prompt-Tresor: Copy-Audit für Prototyp-Screens
Sobald die Screens stehen, lauft ihr die Texte durch dieses Review — idealerweise mit Claude oder ChatGPT auf dem zweiten Monitor:
Du bist UX-Writer. Ich poste dir Screenshots aus einem Figma-Prototyp für ein MVP.

Für jeden Screen bewerte:
1. Versteht ein erstmaliger Nutzer in unter 5 Sekunden, was hier passiert?
2. Gibt es Fachjargon, der in die Nutzersprache übersetzt werden muss?
3. Ist der primäre CTA eindeutig — und löst er das Bedürfnis des Screens ein?

Format pro Screen:
- Verständlichkeit (1–5) + 1-Satz-Begründung
- Konkrete Textänderungen mit Vorher/Nachher
- Ein Risiko-Flag, falls der Screen den Flow bricht.
Phase 3. Validate: UX-Test mit echten Nutzern
Zwischen Prototyp und Code liegt der wichtigste Checkpoint im ganzen Sprint. Fünf echte Nutzer auf den Prototyp loslassen deckt nach der bekannten Rechnung der Nielsen Norman Group rund 85 % der Usability-Probleme auf. Das ist mehr, als jedes Dashboard, jeder KI-Review und jede Team-Diskussion findet.
Vor-Check mit AI-Personas (optional, aber stark)
Bevor ihr echte Menschen einladet, nehmt eine Stunde und lasst drei KI-Personas über den Prototyp laufen. Das ersetzt keine echten Nutzer — aber es findet die dümmsten Fehler, bevor fünf Kalendertermine blockiert sind.
Prompt-Tresor: AI-Persona Prototyp-Review
Du bist [PERSONA — z.B. „Gründerin eines Handwerksbetriebs, 42, wenig Tech-Affinität"].

Du siehst diesen Prototyp zum ersten Mal: [SCREENSHOT oder Figma-Link].

Laufe durch den Flow und schreibe mir in First-Person:
1. Was verstehst du auf dem ersten Screen nicht?
2. Was würdest du als erstes klicken — und warum?
3. An welcher Stelle würdest du abbrechen?
4. Was fehlt dir, um dem Produkt zu vertrauen?

Kein Marketing-Sprech. Schreib wie du dir selbst ein Bier bestellst.
Der echte Nutzertest
Fünf Nutzer, jeder einzeln, 30 Minuten Zoom, Bildschirmaufnahme mit Einverständnis. Die drei Fragen, die den meisten Erkenntnisgewinn bringen:
- 01„Zeig mir, wie du [KERN-AUFGABE] lösen würdest.“ — Beobachten, nicht helfen.
- 02„An welcher Stelle warst du unsicher, was als nächstes passiert?“ — Nach jedem Flow.
- 03„Was müsste dieses Produkt tun, damit du es heute kaufen würdest?“ — Zum Abschluss.
Output: eine priorisierte Änderungsliste — getrennt nach „vor dem Build anpassen“ und „ins V1.1-Backlog“. Änderungen, die drei von fünf Nutzer nennen, sind Must-Fix.
Phase 4. Build: funktionaler Code mit Claude Code und Cursor
Erst hier wird gebaut. Wer in Phase 4 feststellt, dass ein Feature doch nicht gebraucht wird oder ein Flow falsch gedacht ist, hat die vorherigen Phasen nicht ernst genommen — und zahlt jetzt die Rework-Kosten.
Der Tech-Stack, den wir 2026 standardmäßig wählen
Frontend
Next.js 16 + Tailwind CSS v4
React Server Components, gutes DX-Tooling, KI-Tools sind optimal darauf trainiert.
Backend
Supabase (Postgres + Auth + Storage)
DSGVO-Region in Frankfurt, Auth out-of-the-box, Row Level Security.
Hosting
Vercel (Region fra1)
Edge-Deployment, Preview-URLs, automatische Vorschau pro Commit.
AI-Coding
Claude Code (Terminal) + Cursor (IDE)
Autonome Tasks in Claude Code, interaktives Pair-Programming in Cursor.
Wann Claude Code, wann Cursor?
- Claude Code für: neue Features, Refactorings, Test-Suites, alles was klare Task-Beschreibung hat.
- Cursor für: Debugging, UI-Feinschliff, Tailwind-Anpassungen, Mehrfach-Edits in kurzer Folge.
Prompt-Tresor: CLAUDE.md-Boilerplate für ein neues MVP
Der erste Commit jedes Projekts: eine CLAUDE.md im Repo-Root, die Claude Code den Kontext gibt, den sonst niemand schreibt. Diese Vorlage schont euch in jedem Feature-Loop einen halben Tag Erklärung:
# Projekt: [NAME]

## Kontext
- Produkt: [1 Satz, was es tut]
- Zielgruppe: [Wer nutzt es, welches Problem löst es]
- Aktuelle Phase: MVP (Clarity-before-Code Sprint, Phase 4)

## Tech-Stack
- Framework: Next.js 16 App Router + TypeScript strict
- Styling: Tailwind CSS v4 mit CSS-Variablen in globals.css
- Backend: Supabase (EU-Region), Row Level Security auf allen Tabellen
- Auth: Supabase Auth mit E-Mail + Magic Link
- Testing: Vitest + Playwright für Flows

## Konventionen
- Komponenten unter src/components/
- Server Actions statt API Routes, wenn möglich
- Keine Kommentare im Code, die erklären WAS — nur WARUM bei echten Überraschungen
- Strings für UI immer über Dictionary in src/dictionaries/de.ts

## Was NICHT zu tun
- Keine neuen Dependencies ohne Rückfrage
- Keine strukturellen Umbauten ohne Plan-Modus
- Kein Auskommentieren — löschen, wenn Code tot ist
Prompt-Tresor: Supabase Row Level Security in 3 Minuten
Ich baue eine Supabase-Tabelle "[TABELLE]" mit den Spalten:
[SPALTEN mit Typen].

Generiere mir:
1. Die CREATE TABLE Statement mit allen Constraints.
2. Row Level Security Policies für:
   - SELECT: Nutzer sieht nur eigene Zeilen (user_id = auth.uid())
   - INSERT: Nutzer kann nur mit eigenem user_id inserten
   - UPDATE: Nur eigene Zeilen, nur bestimmte Felder
   - DELETE: Nur eigene Zeilen
3. Einen Seed-Eintrag für lokale Tests.

Format: SQL-Block, sofort in Supabase Editor einfügbar.
Sicherheits-Leitplanken: was KI-Code fast nie von allein richtig macht
KI-Tools schreiben Code, der funktioniert. Ob er sicher ist, prüfen sie nicht von allein. In unserem Radar fanden wir bei 24 % (109 von 454) der KI-Apps Schreibzugriffe direkt aus dem Browser in die Datenbank. Das ist nicht automatisch eine Lücke, aber dann hängt alles an einer einzigen Stelle: den Datenbankregeln. Diese fünf Leitplanken gehören deshalb in jeden Build, bevor echte Nutzer kommen:
- 1Row Level Security auf jeder Tabelle. Ohne Row Level Security kann jeder mit dem öffentlichen Schlüssel alle Zeilen lesen. Nach jeder neuen Tabelle prüfen, nicht nur am Anfang.
- 2Der Service-Role-Key bleibt auf dem Server. Der Service-Role-Key umgeht alle Regeln. Er gehört in Server-Code und Umgebungsvariablen, nie in ein Client-Bundle oder einen Prompt.
- 3Geheimnisse nicht ins Repository. Die .env-Datei steht in der .gitignore, bevor der erste Commit passiert. KI-Agenten legen sie gern an und committen sie gleich mit.
- 4Rollen auf dem Server prüfen. Ein ausgeblendeter Admin-Button schützt nichts. Wer was darf, entscheidet der Server oder die Datenbank, nicht die Oberfläche.
- 5Security-Header setzen. Eine Content-Security-Policy fehlte bei 98 % (444 von 454) der Apps im Radar. Startet im Report-Only-Modus und verschärft dann schrittweise.
Ob eure App von außen eine dieser Lücken zeigt, prüft der kostenlose decivo Scan in wenigen Minuten. Wie ihr aus einem Vibe-Code-Prototyp schrittweise Produktionscode macht, beschreiben wir in Vibe Coding: vom Prototyp zum Produkt und Ist KI-Code produktionsreif?.
Phase 5. Ship: Deploy, Analytics, die ersten 48 Stunden
Deployment auf Vercel dauert bei sauberem Next.js-Setup unter fünf Minuten: Repository connecten, Environment-Variablen setzen, Deploy-Button. Die kritischen Schritte passieren vorher und nachher — nicht beim Deploy selbst.
Der Prelaunch-Check in 6 Punkten
- 1Eigene Domain und HTTPS gesetzt (Vercel erledigt das Zertifikat automatisch)
- 2Impressum und Datenschutzerklärung von jeder Seite aus verlinkt. Gesetzlich verlangt, auch für MVPs; im Radar fehlten die Pflichtangaben sichtbar verlinkt bei 16 % (71 von 454) der Apps
- 3Analytics eingebunden, die ohne Einwilligung auskommen oder erst nach Einwilligung laden (z. B. Plausible, PostHog in der EU)
- 4Fehler-Logging aktiv: mindestens strukturierte Logs, besser GlitchTip oder Sentry
- 5Ein Feedback-Kanal: ein Button „Was fehlt dir?“, die Antworten landen direkt in eurem Postfach
- 6Ein letzter Außen-Check: Security-Header, Fremd-Hosts, Tracker vor Einwilligung. Genau das prüft der decivo Scan
Die ersten 48 Stunden nach Launch
Resonanz-Messen passiert in drei Schritten: Minute 0 bis Stunde 24 ist Bug-Fixing-Zeit, Stunde 24 bis Stunde 48 ist Conversion-Messung, ab Tag 3 beginnt die Iterations-Schleife. Wer in den ersten 48 Stunden radikale Features nachschiebt, verwirrt die ersten Nutzer und überfordert das eigene System.
MVP und DSGVO: Supabase, KI-Tools und EU-Server richtig einstellen
Die meisten internationalen Leitfäden zu KI-MVPs lassen diesen Abschnitt weg. Für Gründer im DACH-Raum wird genau hier aus einem schnellen Launch eine Abmahnung oder eine unangenehme Frage vom Kunden. Die gute Nachricht: Mit sechs Einstellungen räumt ihr die häufigsten Probleme ab.
Supabase
Projektregion Frankfurt (eu-central-1) oder Dublin (eu-west-1) wählen + DPA über supabase.com/dashboard/org/_/legal anfordern.
Vercel
Production-Region fra1 setzen. Default ist iad1 (Washington) — Daten verlassen sonst die EU.
Analytics
Plausible (EU-gehostet) oder PostHog mit EU-Hosting. Google Analytics braucht in Deutschland eine Einwilligung, bevor das Skript lädt.
Schriften
Google Fonts lokal ausliefern statt zur Laufzeit von Google zu laden. KI-Builder binden sie oft per Link ein; im Radar betraf das 36 % (165 von 454) der Apps.
Einwilligung
Tracker und Marketing-Pixel erst nach dem Klick auf „Akzeptieren“ laden, nicht schon beim Seitenaufruf. Das im Browser-Netzwerk-Tab nachprüfen.
KI-Tools
Keine personenbezogenen Nutzerdaten in Claude- oder ChatGPT-Prompts. Für die Code-Generierung reichen synthetische Testdaten.
Speziell für Lovable-Apps haben wir die Rechtslage ausführlicher aufgeschrieben: Ist Lovable DSGVO-konform?
Das ist keine Rechtsberatung. Für die konkrete Compliance eures Produkts — besonders bei Gesundheits-, Finanz- oder Kinderdaten — holt eine Stunde mit einem Datenschutzexperten. Die Stunde zahlt sich beim ersten DSGVO-Anruf zehnfach aus.
Was 454 KI-Apps beim Launch falsch machen: eigene Daten
Wir prüfen regelmäßig öffentlich erreichbare KI-Apps mit DACH-Bezug, gebaut mit Lovable, Bolt, Base44 und ähnlichen Werkzeugen, von außen mit demselben Verfahren wie der decivo Scan. Im Lauf „Panel 2026-10-01“ (abgeschlossen am 2. Oktober 2026, Methodik 2026.33) waren es 454 Apps. Ergebnis: 18 % (83 von 454) bekamen das Urteil Go, 81 % (367 von 454) Iterate, 1 % (4 von 454) Stop. Die häufigsten Befunde, die direkt mit diesem Workflow zu tun haben:
| Befund | Anteil |
|---|---|
| Keine Content-Security-Policy | 98 % (444 von 454) |
| Google Fonts zur Laufzeit geladen | 36 % (165 von 454) |
| Daten an Drittland-Dienste (Basis: Apps mit Browser-Lauf) | 33 % (130 von 392) |
| Browser schreibt direkt in die Datenbank | 24 % (109 von 454) |
| Impressum oder Datenschutzerklärung nicht sichtbar verlinkt | 16 % (71 von 454) |
| US-Tracker (Google Analytics/Tag Manager, Meta Pixel, Hotjar, Segment) im ausgelieferten Code eingebunden | 16 % (71 von 454) |
| Tracker feuern vor der Einwilligung (Basis: Apps mit Browser-Lauf) | 15 % (58 von 392) |
Basis 392 (Apps mit Browser-Lauf) bei Befunden, die nur mit einer Laufzeitprüfung im Browser messbar sind. Ein Außen-Scan sieht nur, was öffentlich ausgeliefert wird; ein gutes Ergebnis belegt keine sichere Datenbank. Alle Zahlen, Methodik und Download (CC BY 4.0): KI-App-Radar DACH.
Was das für euren Build heißt: Die Probleme liegen selten in der Idee, fast immer in Konfiguration und Gewohnheiten der Tools. Fast alle davon lassen sich in Phase 4 und 5 mit wenigen Zeilen vermeiden, wenn ihr sie auf die Checkliste setzt.
Was kostet ein MVP mit KI? Agentur, Sprint und Tools im Vergleich
Die Tabelle basiert auf drei decivo-Projekten aus dem ersten Quartal 2026 und klassischen Agenturangeboten aus derselben Zeit. Die Sprint-Zahlen enthalten die Arbeitszeit eines zweiköpfigen Teams zu branchenüblichen Tagessätzen, nicht nur Tool-Kosten.
Zeit- und Kostenvergleich pro Phase
| Phase | Klassische Agentur | Clarity-before-Code Sprint | Ersparnis |
|---|---|---|---|
| Konzeption & Feature-Scope | 2–3 Wochen | 1–2 Tage | ~80 % |
| UI/UX Design & Prototyp | 3–4 Wochen | 2–3 Tage | ~85 % |
| UX-Validierung | 2 Wochen (oft übersprungen) | 2–5 Tage | Wird überhaupt gemacht |
| Entwicklung | 2–4 Monate | 5–10 Tage | ~85 % |
| Deployment & Analytics | 1–2 Wochen | 1–2 Tage | ~90 % |
| Gesamt | 4–7 Monate / 30.000–80.000 € | 2–4 Wochen / 5.000–15.000 € | ~80 % Zeit · ~75 % Kosten |
Arbeitszeit bleibt der größte Kostenblock. Der Sprint verkürzt sie deutlich, ersetzt sie aber nicht.
Tool-Kosten pro Monat (Stand 20. Oktober 2026)
| Tool | Tarif für ein MVP | Preis |
|---|---|---|
| Claude (inkl. Claude Code) | Pro, bei viel Agent-Arbeit Max | 20 $ / ab 100 $ |
| Cursor | Plus oder Premium | 8 $ / 30 $ |
| Supabase | Free zum Start, Pro für den Launch | 0 $ / ab 25 $ zzgl. Compute |
| Vercel | Pro (Hobby ist nur für private, nicht-kommerzielle Projekte) | 20 $ |
| Plausible | Starter | ab 9 $ |
Preise laut Anbieterseiten, ohne Steuern, Änderungen vorbehalten. Der MVP-Kostenrechner rechnet für den DIY-Weg mit 45 € bis 220 € im Monat, inklusive Credit-Überschreitungen bei Lovable, Bolt oder Replit.
Wer den Build nicht selbst macht, hat zwei Festpreis-Wege bei uns: einen Code Prototype für 12.500 € (jeder weitere Prototype Loop 4.500 €) oder, für reine Websites, ab 2.950 €. Wie sich Agentur, Studio und Selbstbau für euren Umfang rechnen, zeigt der MVP-Kostenrechner; die Hintergründe stehen in Was kostet ein MVP?. Ehrlich bleibt: Beim Selbstbau rechnet der Rechner je nach Umfang mit 20 % bis 75 % Wahrscheinlichkeit, dass vor dem Launch professionell nachgearbeitet werden muss.
Vom MVP zum V1: was nach dem Launch kommt
Ein MVP ist kein Ziel, sondern ein Startpunkt. Was danach passiert, hängt vom Signal der ersten zwei Wochen ab. Drei realistische Szenarien:
Kein Interesse
Pivot oder Stop. Ihr habt unter 15.000 € investiert statt 80.000 € — und vier Wochen gebraucht statt sechs Monaten. Das ist ein wirtschaftlich tragbarer Lernmoment, keine Katastrophe.
Interesse mit Korrekturbedarf
Iterations-Schleife in 1-Wochen-Sprints. Weiter mit Claude Code und Cursor. Jede Änderung beginnt wieder mit Phase 3 — Änderungen ohne Nutzer-Feedback sind Halluzinationen.
Product-Market-Fit
Jetzt wird skaliert. Ab diesem Punkt macht der Wechsel von AI-Solo zu festem Team Sinn — für Qualität, Sicherheit und die Geschwindigkeit, die bei 1000+ Nutzern zählt. Worauf ihr bei der Auswahl achten solltet, steht im Leitfaden MVP-Agentur finden.
Wer diesen Workflow macht, und wann ihr decivo braucht
Der Clarity-before-Code Sprint ist kein Geheimnis. Jedes Team, das KI-Tools, Figma und einen modernen Stack beherrscht, kann ihn umsetzen. Die ehrliche Frage ist nicht „können wir es selbst?“, sondern „wollen wir jetzt den Workflow lernen oder das Produkt haben?“.
Wer den Workflow selbst lernen will
Macht es selbst — mit unseren Prompts
Dieser Artikel enthält alle Bausteine. Plant zwei Wochen für das erste Projekt ein und rechnet 30 % Lernsteuer ein. Beim zweiten Projekt greift der Workflow.
Wer das Ergebnis braucht, nicht die Lernkurve
decivo komprimiert den Sprint in festpreisige Module
Innovation Workshop für Phase 1 (7.500 €), Clickable Prototype für Phase 2 (3.500 €), UX Validation Loop für Phase 3 (1.350 € je Loop), Code Prototype für Phase 4 (12.500 €). Jedes Modul zum Festpreis und auf ein Ergebnis terminiert, nicht nach Stunden.
Wer schon einen KI-Prototyp hat
Erst prüfen, dann gezielt reparieren
Der decivo Scan prüft eure App kostenlos von außen. Danach schließt die Sofort-Absicherung alle offenen Lücken hoher Schwere zum Festpreis von 540 €; der Reparaturplan (349 €) zeigt jede Fundstelle mit Lösung. Alle Wege stehen unter Vibe Code Rescue.
Unsere Positionierung: Wir sind kein Ersatz für einen fähigen Gründer, sondern der schnellste Weg, den Sprint professionell zu durchlaufen, ohne zwei Monate Tool-Lernkurve aufzubauen. Teams, die uns buchen, liefern danach oft allein weiter — weil sie Phase 1 bis 4 mit uns einmal komplett erlebt haben.
Der Clarity-before-Code Sprint ist keine Marketing-Erfindung, sondern der Workflow, mit dem wir MVPs bauen. Wer ihn selbst fahren will, findet hier den vollständigen Bauplan. Wer schon gebaut hat, startet mit dem kostenlosen decivo Scan oder schaut sich die Wege unter Vibe Code Rescue an. Alle Module mit Preisen stehen unter Leistungen.
Konkret für euer Projekt einschätzen lassen: Erstgespräch buchen: 30 Minuten, kostenlos, ergebnisoffen.
Quellen
Alle Zahlen in diesem Artikel stammen aus den folgenden Veröffentlichungen. Wo wir eigene Daten verwenden, ist die Erhebung im Text benannt.
- decivo — KI-App-Radar DACH, Lauf „Panel 2026-10-01“ (n = 454, Methodik 2026.33, CC BY 4.0)
- Nielsen Norman Group — Why You Only Need to Test with 5 Users
- Supabase — Privacy, GDPR & Data Processing Addendum
- Supabase — Row Level Security (Dokumentation)
- Anthropic — Claude Code Dokumentation
- Vercel — Configuring regions for Vercel Functions
- Preisseiten (abgerufen 20.10.2026): Claude, Cursor, Supabase, Vercel
- Cursor — Pricing
- Supabase — Pricing
- Vercel — Pricing (Hobby nur für private, nicht-kommerzielle Nutzung)
Häufige Fragen zum KI-MVP-Workflow
Kann man mit KI ein MVP bauen?
Ja. 2026 schreiben Claude Code, Cursor oder Lovable den größten Teil des Codes für ein funktionierendes MVP mit Login, Datenbank und Bezahlfunktion. Was die KI nicht übernimmt: das richtige Problem auswählen, den Umfang begrenzen, mit Nutzern testen und den Code auf Sicherheit prüfen. Genau dafür gibt es die fünf Phasen dieses Workflows.
Wie lange dauert es, ein MVP mit KI zu bauen?
Zwei bis vier Wochen für ein funktionierendes MVP mit echtem Backend, wenn ihr dem Clarity-before-Code Sprint folgt: ein bis zwei Tage Problem und Scope, zwei bis drei Tage Prototyp, zwei bis fünf Tage Nutzertest, fünf bis zehn Tage Build, ein bis zwei Tage Launch. Wer länger braucht, hat meist den Umfang nicht eng genug gezogen, nicht zu langsame Tools.
Was kostet ein MVP mit KI?
Die Tools kosten laut unserem Kostenrechner rund 45 € bis 220 € im Monat (Claude oder Lovable, Supabase, Hosting). Der große Posten ist Arbeitszeit: Teams, die den Workflow beherrschen, landen inklusive Arbeitszeit bei 5.000 bis 15.000 €. Lasst ihr bauen, kostet bei decivo ein Code Prototype 12.500 € zum Festpreis, jeder weitere Prototype Loop 4.500 €.
Claude Code oder Cursor: was ist besser für ein MVP?
Beides hat seinen Platz. Claude Code arbeitet als Agent im Terminal und eignet sich für klar beschriebene Aufgaben wie neue Features, Refactorings und Tests. Cursor ist die Entwicklungsumgebung für Debugging und Feinschliff. Unsere Faustregel: Claude Code für Features, Cursor für Details. Wer nur eines nimmt und wenig Erfahrung hat, startet mit Cursor.
Kann ich ein MVP mit KI ohne Programmierkenntnisse bauen?
Für einen testbaren Prototyp ja, mit Lovable, Bolt oder v0. Für ein MVP, in dem echte Kundendaten liegen, braucht ihr jemanden, der den Code lesen und prüfen kann. Der Kostenrechner setzt beim Selbstbau ohne Programmiererfahrung deutlich mehr Stunden an, weil die letzten 30 Prozent (Fehlersuche, Rechte, Datenmodell) am meisten Zeit kosten.
Ist KI-generierter Code sicher genug für den Launch?
Nicht ohne Prüfung. In unserem KI-App-Radar (Lauf Panel 2026-10-01, 454 Apps aus dem DACH-Raum) bekamen nur 18 % (83 von 454) das Urteil Go. 98 % (444 von 454) hatten keine Content-Security-Policy, bei 24 % (109 von 454) schrieb der Browser direkt in die Datenbank. Prüft vor dem Launch Row Level Security, Schlüssel und Security-Header, zum Beispiel mit dem kostenlosen decivo Scan.
Ist Supabase DSGVO-konform nutzbar?
Supabase lässt sich datenschutzkonform einsetzen, wenn ihr die Projektregion in der EU wählt (etwa Frankfurt) und den Auftragsverarbeitungsvertrag (DPA) über das Dashboard abschließt. Dazu Row Level Security auf allen Tabellen und Vercel auf die Region fra1. Das ist keine Rechtsberatung; bei Gesundheits- oder Finanzdaten holt euch eine Datenschutzberatung dazu.
Passende Artikel
- MVP-Umsetzung
MVP Tools 2026: No-Code und KI-Tools im Vergleich
Lovable, Bolt, Base44, Bubble, FlutterFlow, Softr, Cursor und Claude Code mit Preisen vom Oktober 2026, Code-Export und Stack-Empfehlungen. Dazu eigene Radar-Daten aus 454 DACH-Apps: was diese Tools live ausliefern.
- MVP-Umsetzung
Was kostet ein MVP 2026? Echte Preise statt Spannen
Was ein MVP 2026 kostet, je Typ aus dem MVP-Kosten-Index: Agentur nach Stundensatz gegen AI-native Festpreise, laufende Kosten nach dem Launch, versteckte Kosten bei Sicherheit und DSGVO (mit Radar-Daten aus 454 Apps) und ein Rechner für euren Fall.
- KI-Codequalität
Lovable Alternativen 2026: 10 Tools ehrlich verglichen
Bolt.new, Base44, v0, Replit, Cursor, Claude Code, Bubble und mehr: Preise mit Stand Oktober 2026, die DSGVO-Fakten zu Lovable und eigene Radar-Daten aus 454 KI-gebauten DACH-Apps. Plus die ehrliche Frage: Tool-Problem oder Skill-Problem?