AI Due Diligence 2026: Wie Pre-Seed-Startups einen echten Tech-Moat bauen
2026 investiert kein namhafter VC mehr in dünne AI-Wrapper. Wer beim nächsten OpenAI-Update nicht sterben will, braucht einen echten Burggraben. Hier ist die Architektur, die ihn beweisbar macht — plus die Formel, mit der ihr euer eigenes Risiko testet.
Einen echten Tech-Moat baut ihr 2026 nicht mit einem besseren Prompt, sondern mit etwas, das sich nicht abschreiben lässt: proprietäre Daten aus dem eigenen Betrieb, ein Workflow, der tief in bestehende Systeme eingreift, und Wechselkosten, die mit jedem Monat Nutzung steigen. Genau das prüft die Tech-Due-Diligence — nicht das Modell, sondern was von eurem Vorsprung bleibt, wenn morgen jemand dasselbe Modell benutzt.
Jedes Mal, wenn OpenAI oder Google ein Update ausliefert, verschwinden Startups, die nur eine dünne Oberfläche auf eine fremde API gesetzt haben. Die Branche nennt das „Sherlocking“ — und 2026 ist es kein Randphänomen mehr, sondern das zentrale Plattformrisiko jeder Pre-Seed-Runde im AI-Bereich.
Auf Englisch gibt es dazu fundierte Analysen von Andreessen Horowitz und Sequoia. Auf Deutsch fehlt bislang die konkrete, technische Anleitung: nicht „baut einen Moat“, sondern welche Schichten, welche Datenbank, welche Architektur — und woran ein Tech-Auditor im Investoren-Call erkennt, ob er echt ist.
Genau diese Lücke schließt dieser Artikel. decivo ist ein Lean Software Studio nach dem Prinzip Clarity Before Code — wir bauen Prototypen und Code Prototypes, damit Teams fundiert entscheiden, bevor Entwicklung teuer wird. Die folgende Architektur nutzen wir, wenn Gründer fragen: „Würde unser MVP eine technische Due Diligence überstehen?“
TL;DR — die 6 Kernpunkte
- Sherlocking: Eine große Plattform integriert euer Feature nativ — und entwertet dünne Wrapper über Nacht. 2025/2026 traf das genau die Startups ohne eigenen Datenschatz oder Workflow-Tiefe.
- Ein AI-Moat 2026 ist nicht das Modell. Er besteht aus drei Schichten: System-of-Workflow Moat, Proprietary Context Engine, Agentic Orchestration.
- a16z-Nuance: Rohdaten sind kein Moat. Der Moat ist die Veredelungs-Pipeline, die aus Nutzung kompoundenden Kontext macht.
- Sherlock-Risiko = (API-Abhängigkeit × UI-Kopierbarkeit) ÷ proprietäre Kontext-Tiefe. Jeder Faktor 1–10, klare Risikobänder.
- Investierbar wird ein MVP in 3 Schritten: Context Isolation & Vektor-DB, Agentic Orchestration statt Single Prompt, Workflow-Integration mit messbaren Wechselkosten.
- decivo klärt die Moat-Architektur im Innovation Workshop (7.500 € netto) und baut den technischen Beweis bei Bedarf als Code Prototype (12.500 € netto) — Clarity Before Code.
Der Tod des AI-Wrappers: Warum VCs 2026 ablehnen
Ein AI-Wrapper ist ein Produkt, dessen gesamter Wert im fremden Modell steckt: Prompt rein, Antwort raus, eine UI drumherum. Das Problem ist nicht, dass es nicht funktioniert — es funktioniert oft hervorragend. Das Problem ist, dass es niemandem gehört.
2025 lieferten OpenAI mit AgentKit und Anthropic mit „Skills“ Funktionsschichten aus, die ganze Kategorien von Workflow-Automatisierungs-Startups über Nacht überflüssig machten. Anfang 2026 warnte ein Google-VP öffentlich, dass zwei Typen von AI-Startups nicht überleben werden — an erster Stelle die reinen Modell-Wrapper. Die Geduld der Investoren mit „white-gelabelten Modellen“ ist aufgebraucht.
Definition
Sherlocking (AI, 2026)
Sherlocking bezeichnet die Praxis, dass eine dominante Plattform eine Funktion, die bisher ein Drittanbieter angeboten hat, nativ in das eigene Produkt integriert — und damit die Existenzgrundlage des Drittanbieters entwertet. Bei AI-Startups trifft es Produkte, deren einzige Wertschöpfung der Modellzugriff war.
Der Umkehrschluss ist die gute Nachricht: Ein Plattform-Update ist für ein Wrapper-Startup eine Bedrohung — für ein Startup mit echtem Moat ist es ein Rückenwind. Wenn die Foundation-Schicht billiger und stärker wird, profitiert genau das Produkt, dessen Wert nicht im Modell liegt.
Wenn euer Code aus einem schnellen Prototyp stammt: Vibe Coding — vom Prototyp zum Produkt.
Die 3-Tier Moat Architecture
Ein moderner AI-Burggraben besteht 2026 aus drei Schichten. Keine ersetzt die andere — sie stapeln sich. Je mehr Schichten belegbar sind, desto niedriger das Sherlock-Risiko.
System-of-Workflow Moat
Die Tiefe der Integration in den täglichen Arbeitsablauf des Nutzers. Nicht „eine weitere Chat-App“, sondern der Ort, an dem die Arbeit tatsächlich entsteht — mit Daten, Zuständen und Entscheidungen, die der Nutzer nicht migrieren will.
Beweis für VCs: messbare Wechselkosten. Daily/Weekly Active Use, gespeicherte Artefakte pro Konto, Anzahl der angebundenen Drittsysteme. Ein Workflow-Moat zeigt sich in Retention-Kurven, die abflachen statt zu verfallen.
Proprietary Context Engine
Keine Datenhalde — eine Veredelungs-Pipeline. Eigene RAG-Architektur (Retrieval-Augmented Generation), proprietäre Embeddings und ein Feedback-Loop, der aus jeder Nutzung besseren Kontext macht. a16z formuliert es scharf: rohe Daten sind kein Moat, die Veredelung ist es.
Beweis für VCs: Compounding. Antwortqualität steigt mit Nutzungsdauer messbar, nicht mit dem nächsten Foundation-Model-Release. Der Datenschatz ist nur über euer Produkt entstehbar und nicht in 48 Stunden nachbaubar.
Agentic Orchestration
Der Wechsel vom Single Prompt zu autonomen, mehrstufigen Agenten-Systemen mit getyptem geteiltem State, Memory, Self-Correction-Loops und Checkpoints für Recovery. Die Orchestrierung — nicht das Modell — ist die IP.
Beweis für VCs: Robustheit unter Modellwechsel. Das System läuft mit GPT, Claude oder einem lokalen Open-Source-Modell weiter, weil die Logik in der Orchestrierungsschicht steckt — nicht in einem hartcodierten System-Prompt.
Tiefe Workflow-Einbettung · hohe Wechselkosten
Eigene RAG-Pipeline · kompoundende Daten-Veredelung
Autonome Agenten · Memory · Self-Correction
Foundation-Modell
Der wichtigste Satz für jeden Pre-Seed-Pitch: Das Foundation-Modell ist der austauschbare Sockel unter dieser Architektur, nicht die Architektur selbst. a16z bringt es in „The Empty Promise of Data Moats“ auf den Punkt — entscheidend ist nicht, wie viele Daten ihr habt, sondern ob ihr eine Pipeline habt, die sie veredelt.
Die Sherlock-Risiko-Formel
Mit dieser Formel testet ihr euer Startup selbst, bevor es ein VC tut. Sie ist bewusst einfach — sie soll eine Diskussion auslösen, keine Nachkommastelle liefern.
Sherlock-Risiko = (API-Abhängigkeit × UI-Kopierbarkeit) ÷ Proprietäre Kontext-Tiefe
Jeder Faktor wird von 1 (unkritisch) bis 10 (maximal) eingeschätzt. Je höher die reine Abhängigkeit von einer Standard-API und je leichter die Oberfläche kopierbar ist, desto höher das Risiko. Eine tiefe, proprietäre Kontext-Schicht im Nenner drückt das Risiko gegen null.
Die drei Faktoren
API-Abhängigkeit (1–10)
10 = das Produkt ist ohne genau einen Modellanbieter sofort tot. 1 = Modell ist hinter einer Abstraktionsschicht austauschbar, lokaler Fallback existiert.
UI-Kopierbarkeit (1–10)
10 = ein Entwickler baut die Oberfläche in 48 Stunden nach. 1 = der Wert steckt im Workflow und in Daten, nicht in der sichtbaren Oberfläche.
Proprietäre Kontext-Tiefe (1–10)
10 = ein kompoundender, nur über euer Produkt entstehbarer Datenschatz mit Veredelungs-Pipeline. 1 = kein eigener Kontext, reine Weiterleitung.
Risikobänder
- Score ≥ 50 — rotes Tuch. Klassischer Wrapper. Eine technische DD übersteht das nicht.
- Score 15–49 — gelb. Es gibt einen Ansatz, aber mindestens ein Tier ist unbelegt.
- Score < 15 — grün. Belegbarer Moat. Das Plattformrisiko ist strukturell adressiert.
Rechenbeispiel
Reiner GPT-Wrapper: API-Abhängigkeit 9, UI-Kopierbarkeit 8, Kontext-Tiefe 1 → (9 × 8) ÷ 1 = 72. Tief rotes Tuch. Dasselbe Produkt mit eigener Context Engine und Workflow-Verankerung: 4 × 3 ÷ 8 = 1,5. Grün — und genau dieser Sprung ist der Job vor der Pre-Seed-Runde.
Wrapper vs. Moat: der Direkt-Vergleich
Diese Tabelle ist die Checkliste, die ein Tech-Auditor mental abarbeitet. Links das rote Tuch, rechts das grüne Licht — pro Prüfpunkt.
| Prüfpunkt für VCs | Rotes Tuch — einfacher Wrapper | Grünes Licht — echter Tech-Moat |
|---|---|---|
| Tech-Stack | Reiner API-Call zu OpenAI oder Anthropic, dünne UI darüber. | Orchestrierungsschicht (z. B. LangGraph) + austauschbares Modell, inkl. lokaler Open-Source-Fallback. |
| Datenhaltung | Keine Speicherung, nur Weiterleitung des Prompts. | Vektordatenbank (pgvector oder Qdrant) mit proprietären Nutzer-Embeddings und Feedback-Loop. |
| Logik-Ebene | System-Prompt fest in der App verdrahtet. | Autonome Agenten mit Memory, Self-Correction und getyptem State. |
| Kontext | Generisch — dasselbe wie ChatGPT mit anderem Logo. | Pro Konto veredelt — Antworten werden mit Nutzungsdauer besser. |
| Wechselkosten | Nutzer ist in Sekunden weg, nichts geht verloren. | Workflow, Daten und Verläufe sind im Produkt verankert. |
| IP-Schutz | Jeder Entwickler baut es in 48 Stunden nach. | Komplexe, proprietär orchestrierte Schnittstellen — nicht trivial replizierbar. |
| Sherlock-Risiko | Hoch — stirbt beim nächsten Plattform-Update. | Niedrig — Plattform-Update macht das Produkt eher besser. |
So macht ihr euer MVP in 3 Schritten investierbar
Ihr braucht den vollen Moat nicht vor dem ersten Pitch. Ihr braucht eine glaubwürdige Architektur und mindestens einen belegbaren Tier. Diese Reihenfolge hat sich bewährt:
Schritt 1 — Context Isolation & Vektordatenbank
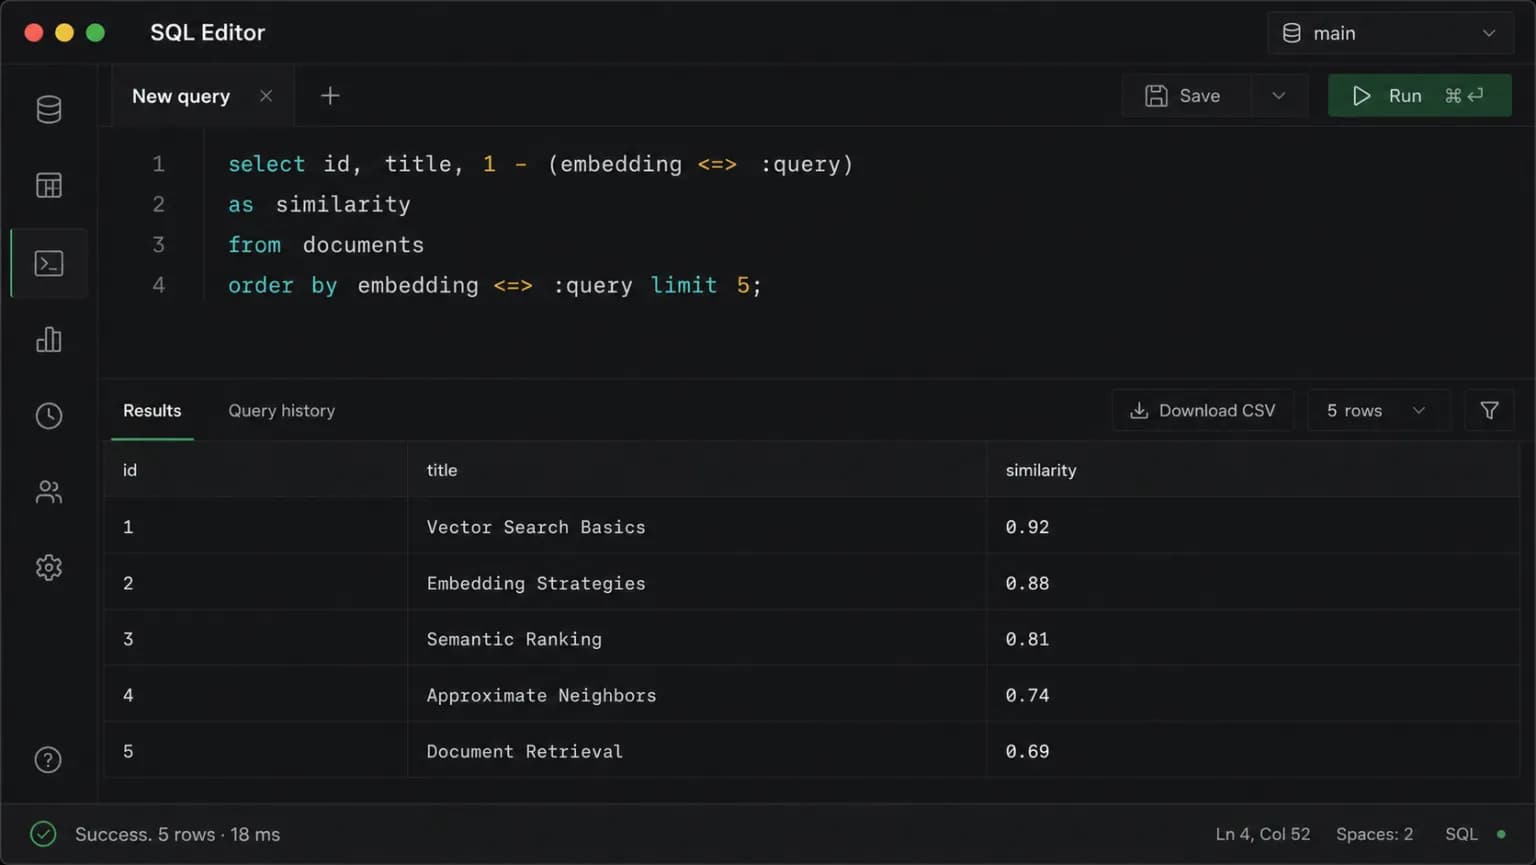
Trennt Nutzerkontext sauber vom Modell. Eigene Embeddings in eine Vektordatenbank: pgvector im bestehenden Postgres unter ~5 Mio. Vektoren, Qdrant darüber oder bei filterlastigen Abfragen. Ab hier entsteht ein Datenschatz, der nur über euer Produkt erreichbar ist — die Basis der Proprietary Context Engine.
Schritt 2 — Agentic Orchestration statt Single Prompt
Ersetzt den hartcodierten System-Prompt durch eine Orchestrierungsschicht mit getyptem geteiltem State, Memory, Self-Correction-Loop und Checkpoints für Recovery (z. B. mit LangGraph). Die Logik wandert aus dem Prompt in eine austauschbare, testbare Schicht — robust gegen Modellwechsel.
Schritt 3 — Workflow-Integration & Wechselkosten
Verankert das Produkt im Arbeitsalltag: gespeicherte Artefakte, angebundene Drittsysteme, Zustände, die der Nutzer nicht migrieren will. Macht die Wechselkosten messbar — genau diese Kurve fragen Investoren in der Tech-DD ab.
Visueller Beleg: links ein Screenshot der pgvector-Similarity-Query mit Treffer und Latenz, rechts ein kurzes Video des Wrapper-zu-Agenten-Umbaus mit sichtbarem Self-Correction-Loop.
Wie der gesamte Weg von der Idee zum Launch aussieht: MVP mit KI bauen — der komplette Workflow.
Der Tech-Due-Diligence-Spickzettel
Zehn Fragen, die im Investoren-Call kommen — und die Richtung der besten technischen Antwort. Nicht auswendig lernen, sondern verstehen: Jede Frage prüft genau einen Tier der Architektur.
Frage: Was passiert mit eurem Produkt, wenn OpenAI morgen genau euer Feature nativ ausliefert?
Beste Antwortrichtung: Beste Antwort: „Wir würden besser werden, weil die Foundation-Schicht günstiger und stärker wird — unser Wert liegt im veredelten Kontext und im Workflow, nicht im Modell.“
Frage: Welche Daten habt ihr, die ein Wettbewerber nicht einfach kaufen oder scrapen kann?
Beste Antwortrichtung: Beste Antwort: proprietäre Daten, die nur durch die Nutzung eures Produkts entstehen, plus die Veredelungs-Pipeline darüber. Rohdaten allein zählen nicht.
Frage: Ist euer Modell austauschbar — oder hängt ihr an einem Anbieter?
Beste Antwortrichtung: Beste Antwort: Modell ist über eine Abstraktionsschicht austauschbar; ein lokales Open-Source-Modell ist als Fallback getestet.
Frage: Wie sieht eure RAG-Architektur aus und wo liegen die Embeddings?
Beste Antwortrichtung: Beste Antwort: konkrete Vektordatenbank (pgvector unter ~5 Mio. Vektoren, Qdrant darüber), eigene Embedding-Strategie, Metadaten-Filter und Re-Ranking erklärbar.
Frage: Was ist Single Prompt und was ist echte Agenten-Orchestrierung in eurem System?
Beste Antwortrichtung: Beste Antwort: klare Grenze ziehen — Single Prompt für triviale Tasks, orchestrierte Agenten mit State und Self-Correction für mehrstufige Workflows.
Frage: Wie messt ihr, dass euer Kontext mit der Zeit besser wird?
Beste Antwortrichtung: Beste Antwort: definierte Qualitätsmetrik (z. B. Task-Success-Rate, menschliche Bewertung) über Kohorten-Alter, nicht über Modell-Releases.
Frage: Wie hoch sind eure Inference-Kosten pro aktivem Nutzer und wie skalieren sie?
Beste Antwortrichtung: Beste Antwort: konkrete Zahl pro Aktion, Caching-Strategie, und der Punkt, ab dem ein kleineres oder lokales Modell übernimmt.
Frage: Wie verhindert ihr Prompt-Injection und Datenabfluss über das Modell?
Beste Antwortrichtung: Beste Antwort: Input-Validierung, Tool-Allowlists, Trennung von Nutzerdaten und Systemkontext, kein Vertrauen auf das Modell als Sicherheitsgrenze.
Frage: Was genau ist hier euer geistiges Eigentum?
Beste Antwortrichtung: Beste Antwort: die orchestrierte Workflow-Logik und die Veredelungs-Pipeline — nicht der Prompt. Ehrlich benennen, was patentierbar ist und was nicht.
Frage: Wenn wir euer Team verdoppeln — was baut ihr zuerst, um den Moat zu vertiefen?
Beste Antwortrichtung: Beste Antwort: priorisierte Roadmap entlang der drei Tiers, mit dem schwächsten Tier zuerst und einer messbaren Hypothese pro Schritt.
Wie decivo den Moat mitbaut
decivo ist ein Lean Software Studio, kein Investoren-Auditor und kein KI-Tool. Wir bauen klickbare Prototypen, validieren mit echten Nutzern und bauen Code Prototypes — damit ihr fundiert entscheidet, bevor Entwicklung teuer wird. Genau diese Methodik passt auf die Moat-Frage.
Im Innovation Workshop (7.500 € netto, inklusive Clickable Prototype) analysieren wir die kritischen Abhängigkeiten eures KI-MVP, berechnen das Sherlock-Risiko und legen die Moat-Architektur entlang der drei Tiers fest — inklusive konkreter Vektordatenbank- und Orchestrierungs-Entscheidung. Das ist Clarity Before Code: erst die Architektur, die VCs unterschreiben lassen, dann der Code.
Wenn der technische Beweis tatsächlich stehen muss — eine lauffähige Context-Engine- und Agenten-Architektur, die eine Tech-DD übersteht —, ist das der Code Prototype (12.500 € netto). Wenn die Richtung klar ist, begleiten wir die Umsetzung weiter oder bauen das Produkt gemeinsam mit euch.
- Innovation Workshop — 7.500 € netto · inkl. Clickable Prototype · Sherlock-Risiko + Moat-Architektur entlang der 3 Tiers.
- Code Prototype — 12.500 € netto · lauffähige Context-Engine- und Agenten-Architektur, die eine Tech-DD übersteht.
- UX Validation Loop — 1.350 € netto pro Loop · echte Nutzer testen den Workflow, der den Tier-1-Moat trägt.
- Prototype Loop — 4.500 € netto pro Loop · iterativ Richtung investierbares MVP schärfen.
Ein 30-minütiges Erstgespräch reicht, um euer Sherlock-Risiko grob einzuordnen — auch wenn die ehrliche Antwort ist, dass ihr noch keinen Workshop braucht. Alle Module ansehen.
Quellen
Alle Zahlen in diesem Artikel stammen aus den folgenden Veröffentlichungen. Wo wir eigene Daten verwenden, ist die Erhebung im Text benannt.
- Andreessen Horowitz — The Empty Promise of Data Moats
- Andreessen Horowitz — The New Business of AI (and How It's Different from Traditional Software)
- TechCrunch — Google VP warns that two types of AI startups may not survive (2026)
- LangChain — LangGraph: Agent Orchestration Framework
- pgvector — Vektorsuche in Postgres
Häufige Fragen zu AI Due Diligence & Tech Moat
Was bedeutet „Sherlocked werden“ bei AI-Startups?
„Sherlocking“ beschreibt, dass eine große Plattform (OpenAI, Google, Microsoft, Anthropic) eine Funktion, die bisher ein Startup angeboten hat, nativ in ihr eigenes Produkt integriert — und damit die Existenzgrundlage des Startups über Nacht entwertet. 2025/2026 traf das vor allem dünne Wrapper ohne eigenen Datenschatz oder Workflow-Tiefe. Der Begriff stammt ursprünglich aus dem Apple-Umfeld (Sherlock vs. Watson) und ist heute der Standard-Begriff für dieses Plattformrisiko.
Was ist ein AI-Moat 2026 konkret?
Ein AI-Moat 2026 besteht aus drei Schichten: einem System-of-Workflow Moat (tiefe Einbettung in den Arbeitsalltag, hohe Wechselkosten), einer Proprietary Context Engine (eigene RAG-Pipeline plus Datenveredelung, die mit Nutzung kompoundet) und Agentic Orchestration (autonome, mehrstufige Agenten statt Single Prompt). Ein Moat ist nicht das Modell — Modelle sind austauschbar und werden ständig billiger.
Kann man für einen AI-Wrapper ein Patent anmelden?
Ein reiner Prompt oder eine UI auf einer fremden API ist in der Regel nicht patentierbar und kaum verteidigbar. Patentierbar kann eine konkrete, neuartige technische Methode sein — etwa ein spezifisches Orchestrierungs- oder Retrieval-Verfahren. Das ist eine Frage für eine Patentanwältin oder einen Patentanwalt; dieser Artikel ist keine Rechtsberatung. Für die meisten Pre-Seed-Startups ist der belastbarere Schutz ohnehin der Workflow- und Kontext-Moat, nicht ein Patent.
Was kostet ein technisches Audit beziehungsweise ein Tech-Moat-Check?
Bei decivo läuft die Moat-Analyse nicht als isoliertes Audit, sondern als Teil des Innovation Workshops (7.500 € netto, inklusive Clickable Prototype). Dort identifizieren wir die kritischen Abhängigkeiten und legen die Moat-Architektur fest. Soll der technische Beweis tatsächlich gebaut werden — eine lauffähige Context-Engine- und Agenten-Architektur —, ist das der Code Prototype (12.500 € netto).
pgvector oder Qdrant — was nehmen wir für die Context Engine?
Faustregel 2026: Unter rund 5 Millionen Vektoren ist pgvector im bestehenden Postgres meist die richtige Wahl — eine Komponente weniger im Betrieb, mit HNSW-Index unter 20 ms p50 bei über 95 % Recall. Über 5 Millionen Vektoren, bei sub-10-ms-Anforderung oder sehr filterlastigen Abfragen spielt Qdrant seine Stärke aus. Der Trend 2026 geht klar Richtung Konsolidierung in die relationale Datenbank.
Reicht ein Vibe-Coding-Prototyp aus Lovable oder Cursor für die Tech-DD?
Für Kundengespräche oft ja, für die technische Due Diligence meist nein. Investoren grillen genau die Stellen, die ein schneller Prototyp überspringt: Datenarchitektur, Kostenstruktur, Modell-Abhängigkeit, Sicherheit. Der Prototyp ist ein guter Startpunkt — investierbar wird er erst mit einer sauberen Moat-Architektur dahinter.
Wie früh sollte ein Pre-Seed-Startup den Moat bauen?
Den vollen Moat braucht ihr nicht vor dem ersten Pitch. Aber ihr braucht eine glaubwürdige Architektur-Story und mindestens einen Tier als belegbaren Anfang — meist die Context Engine oder die Workflow-Integration. VCs erwarten in der Pre-Seed keinen fertigen Burggraben, sondern den Beweis, dass ihr versteht, wo er entsteht, und dass eure Architektur ihn nicht verbaut.
Passende Artikel
- KI-Codequalität
Vibe Coding: Vom Prototyp zum Produkt 2026. Was nach dem ersten Prompt kommt
Vibe-Code-MVP funktioniert, aber der Code ist Chaos? Reifeskala in 4 Stufen, Stack of Truth, Clarity Retrofit Workflow mit Prompts, Vorher/Nachher-Code und 3 Wege zum Produktionscode.
- KI-Codequalität
Ist KI-generierter Code produktionsreif? Was die Studien 2026 wirklich sagen
Eigene Studie: 12 MVP-Features per naivem Prompt erfüllen im Chat-Coding nur 19,6 %, mit dem neuesten Agenten (Codex) 47,1 % der Produktionsreife-Kontrollen — 0 von 12 fertig. Plus alle großen Studien 2026 (Veracode, GitClear, METR) und der Weiterbau-Test mit 5 Fragen.
- KI-Codequalität
Lovable Alternativen 2026: Ehrlicher Vergleich + Was wirklich hilft
Vier Kategorien von Alternativen — von Bolt.new über Cursor bis zum Lean Software Studio. Mit Entscheidungshilfe, ehrlichen Kosten und der wahren Frage: Tool-Problem oder Skill-Problem?
Bereit für die Pre-Seed-Runde? Lasst uns euren Moat klären.
Erzählt uns kurz, was euer KI-MVP tut. Wir ordnen das Sherlock-Risiko ein und sagen ehrlich, welche Schicht zuerst gebaut werden muss — Clarity Before Code.
decivo ist ein Lean Software Studio. Keine Verkaufsmasche — wenn euer Moat schon trägt, sagen wir das.